Core Technology
核心技术
覆盖端侧音频前端、语音交互与声学感知的全栈算法能力。
回声消除
Noise Reduction波束定向拾音
Beamforming声源定位
Sound Source Localization语音唤醒
Voice Wakeup离线识别
Offline Recognition音乐人声分离
Music Separation声纹降噪
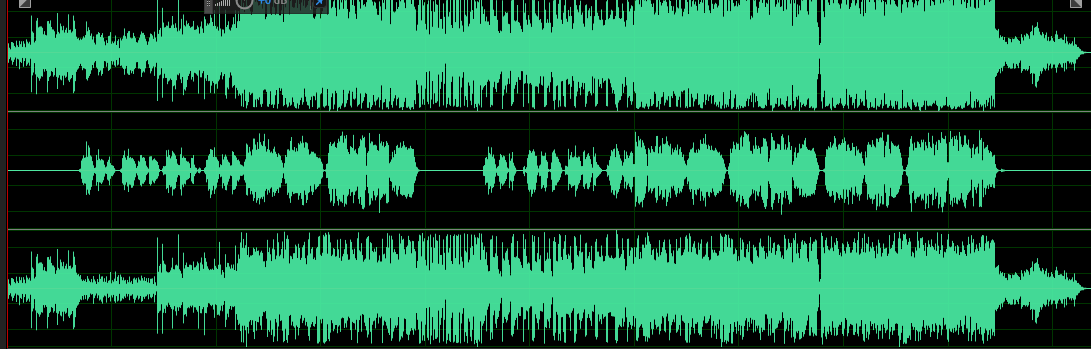
Voiceprint reductionNoise reduction example
语音降噪示例
应用于对讲机,IPC, 录音笔,耳机等等多元终端设备。
支持本地部署
支持云端部署
Example
示例
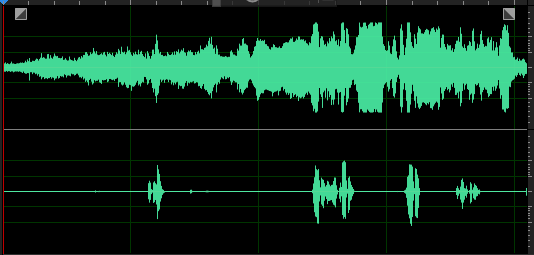
算法前
算法后
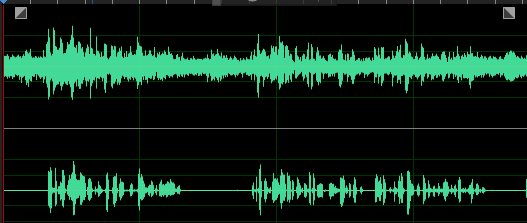
Echo Cancellation Example
回声消除示例
应用于音箱,对讲机,IPC,AI玩具等多元终端设备。
端侧AEC+VAD,支持插话打断、多伦对话。
支持本地部署
支持云端部署
Example
示例
Mix
80KB
120KB
AI-AEC
directional pickup enhancement Example
波束定向拾音增强版示例
采用 4mic 50mm*50mm环形(其他阵型可定制),可指定任意方向输出,支持定向任意角度拾音屏蔽指定方向外的声音并进行环境降噪。
可广泛应用于人形机器人、四足机器人、车载多音区、录音卡等。
Example
示例
四麦环阵
算法后
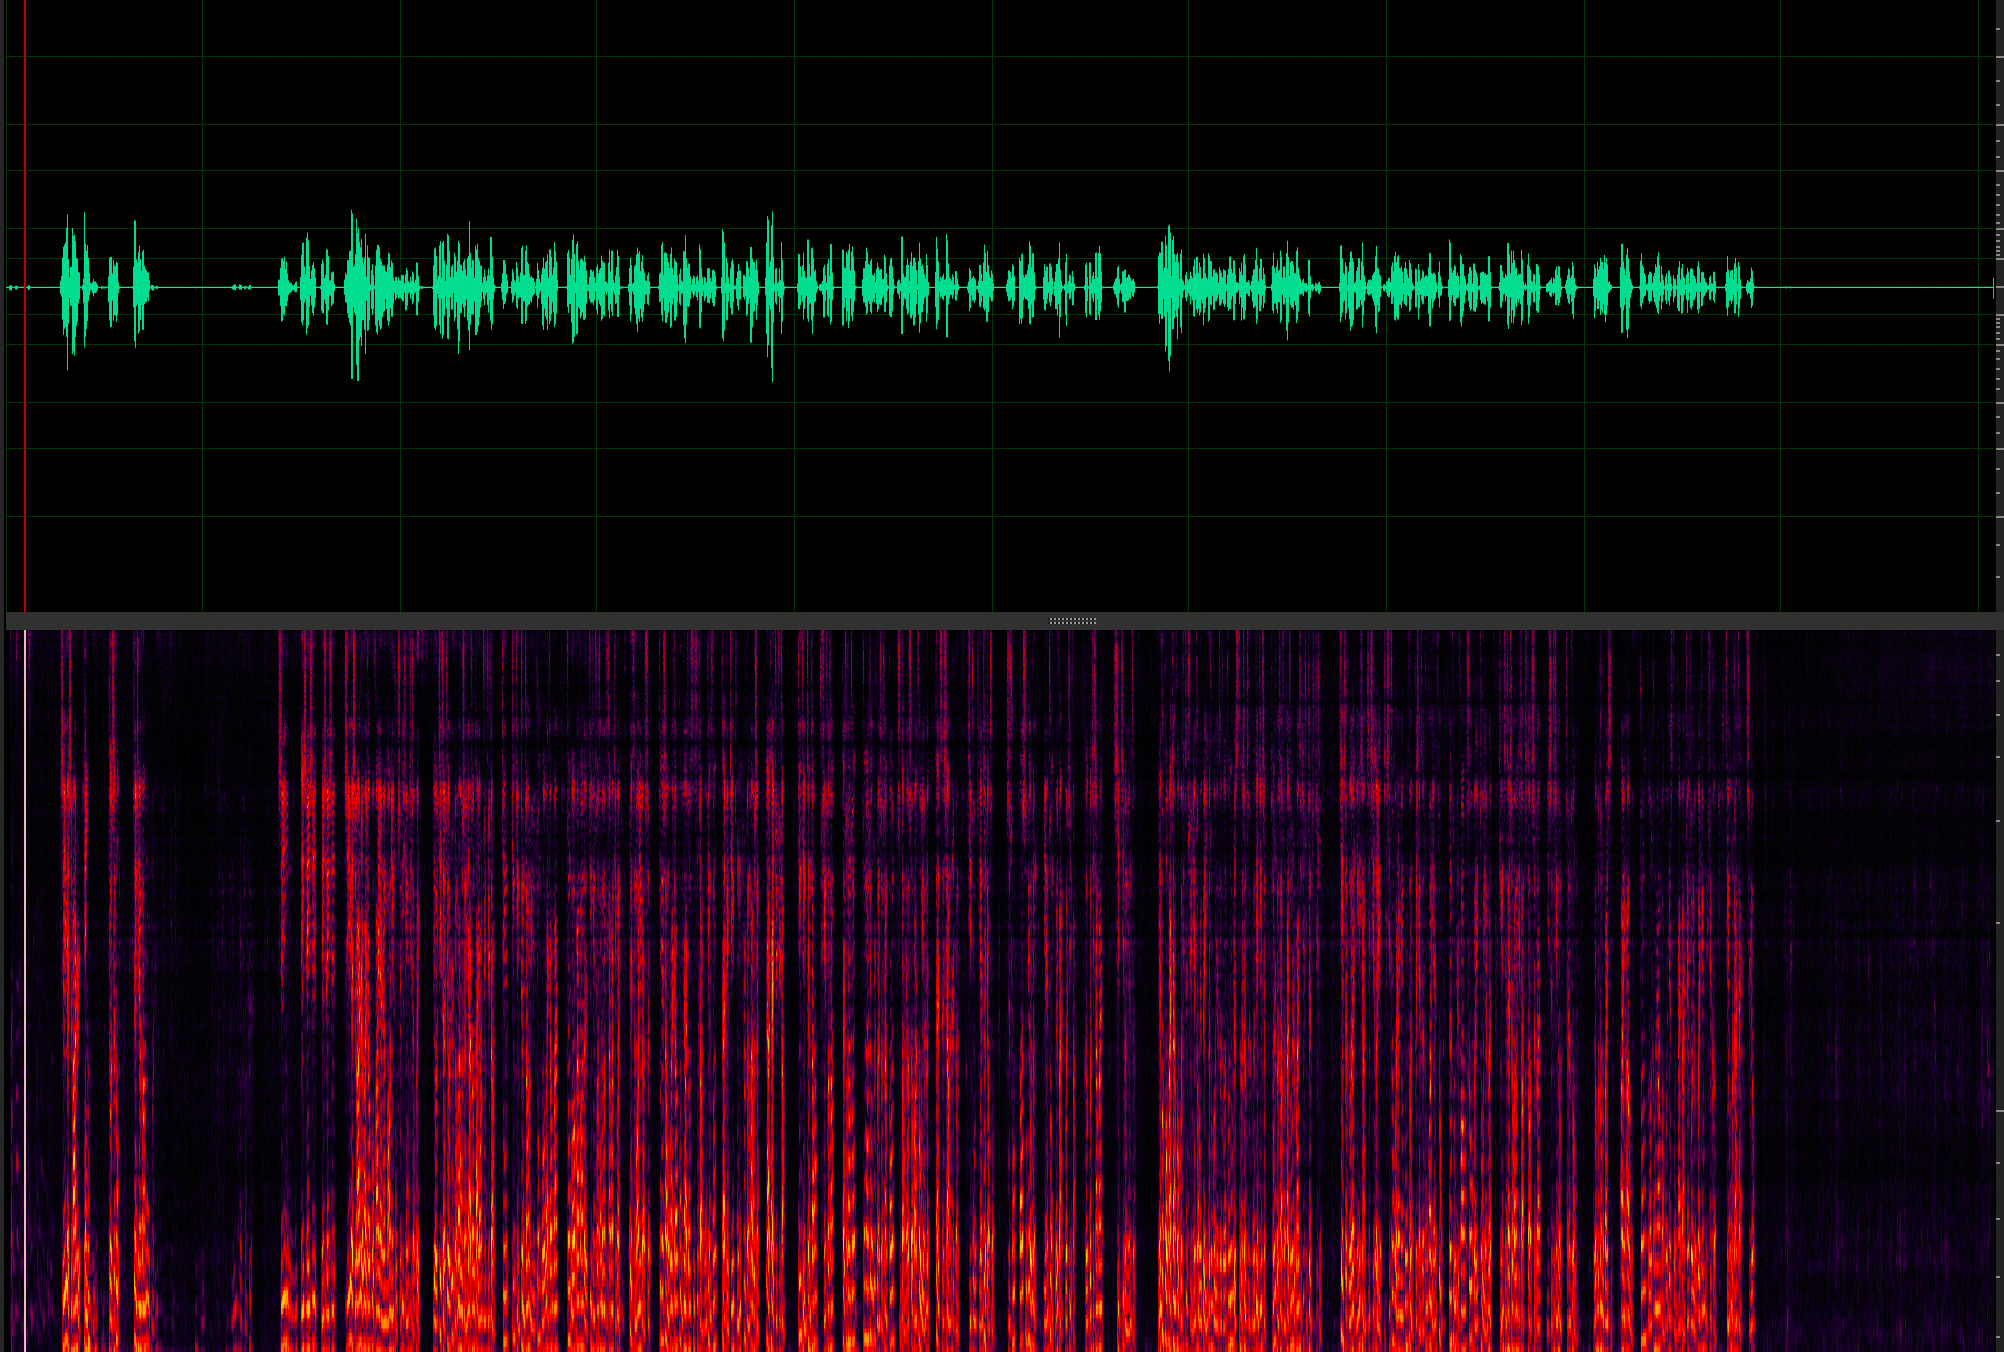
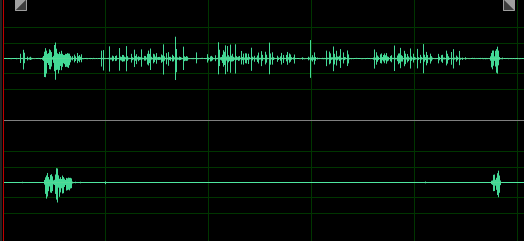
music separation Example
音乐分离示例
基于深度学习的音乐分离技术,支持多种K歌、游戏soundbar、电视、家庭影院音效增强等不同应用场景需求。
| 采样率 | 模型类型 | 延时 | 模型大小 | 声道 | 分离标准 |
|---|---|---|---|---|---|
| 任意采样率 | NN | 非实时 | 20MB | 单/双 | 音乐创作标准 |
| NN | 50ms | 1.2MB | 单/双 | K歌标准 |
Example
示例
原始音频
人声
背景声